- 相关博文
- 最新资讯
-
—采集课爬下来的数据,预处理课清洗,分析课建模,可视化课呈现,四门课共同完成一条完整的“数据生产线”,学生才理解环节之间的依赖。第三,进阶阶段引入大模型辅助数据分析的模块——2026年的企业实践里,用自然语言问数据、让大模型生成分析初稿已经不新鲜,课堂上不讲,毕业生到了岗位会觉得断层。比较完整的配置会覆盖十余个行业领域的脱敏数据:城市交通、法律文书、社会经济、贸易通关、股票金融、政府信息公开、投融资、互联网金融、环境地理、体育、文化娱乐、自媒体、企业征信、电商零售、汽车产业、房地产、人才招聘等。
-

- 武汉唯众智创
- 昨天
-
-
近期 TypeSafe AI 的 Jev 模型引起了不少关注。它不做自回归文本生成,而是给定状态与一组预定义问题,一次前向输出的概率分布与置信度,端到端 70–500 ms。这个变化看似只是「更快更便宜」,实际上改变的是——概率可以直接参与计算,而文本必须经过解析才能变成数字。本文从这一处差异出发,记录一条由浅入深的推导路径。Null只保证不输出选项之外的内容,不保证判断正确,因此「零幻觉」是格式性质而非判断性质。
-

- Dawson Zhu
- 2026-09-22
-
-
Kafka核心术语涵盖生产者、消费者、Broker集群与ZooKeeper协调服务。消息按Topic逻辑分类,通过Partition物理分片实现高并发,同Key消息保序。每个Partition有Leader与Follower副本保障高可用。消费者组内通过Offset记录消费位置,支持Rebalance动态分配分区。关键机制包括acks确认、消息保留策略、DLQ死信队列及异步发送(CompletableFuture)。这些概念共同支撑Kafka的高性能、可扩展与可靠性。
-

- ab123768
- 前天
-
-
如果你的毕业设计卡在方案设计、代码开发、硬件搭建、图纸建模、论文框架等环节,想要针对性定制方案,欢迎扫码一起交流探讨毕设思路、实现方案。每届毕业设计阶段,不少同学都会遇到难题:选题拿捏不准、代码调试卡壳、硬件实物调不通、仿真报错、图纸建模有干涉,论文和答辩准备无从下手。结合多年经验,简单聊聊大数据、单片机物联网、网络工程、PLC 自动化、机械设计这几个方向毕设常见问题。网络工程:拓扑规划不合理,设备配置命令出错,仿真项目达不到工作量要求。机械设计:三维建模装配干涉,工程图纸不规范,有限元仿真不会操作。
-

- 千里码开发设计工作室
- 昨天
-
-
Elasticsearch不支持传统事务,但通过translog保障单文档写入的持久性。写入时,文档并行写入内存缓冲区和translog,待translog fsync后才返回成功。每秒一次的refresh将内存数据批量写入文件系统缓存,实现近实时搜索;而flush则定期将缓存段强制落盘,清空translog。生成segment发生在refresh阶段,非写入确认前。频繁刷新会引发大量小段,影响性能,故默认每秒一次为平衡点。段合并由后台异步执行,与flush解耦,不随flush触发,确保系统稳定。
-

- 最北方
- 昨天
-
-
日志成本高的根源不是"磁盘贵",而是存储模型——Elasticsearch 需要同时保留正排、倒排索引与 Docvalue 三份数据,压缩率被限制在 1.5 倍左右。
-

- SelectDB技术团队
- 前天
-
-
系列:《Apache Doris 全景科普》第 2/15 篇柱:业界进展标签:OLAP、ClickHouse、StarRocks、Hive、Iceberg、Paimon、选型。
-

- felixjbzhu
- 前天
-
-
本文介绍《基于大数据的用户健身行为数据分析与可视化》系统,采用Python(Django)与Java(Spring Boot)双版本开发,结合Hadoop、Spark、MySQL及Vue+ECharts实现数据采集、清洗、分析与可视化。系统涵盖体征画像、训练负荷、饮食结构、能量平衡等多维度分析模块,支持个体与群体洞察,助力科学健身决策。文末可获取源码,适合毕业设计与项目实战参考。
-

- IT研究室
- 前天
-


-
看完这一篇,你就对 Spring Security 略窥门径了
开发Web应用,对页面的安全控制通常是必须的。比如:对于没有访问权限的用户需要转到登录表单页面。要实现访问控制的方法多种多样,可以通过Aop、拦截器实现,也可以通过框架实现,例如:Apache Shiro、Spring Security。我们这里要讲的Spring Security 就是一个Spring生态中关于安全方面的框架。它能够为基于Spring的企业应用系统提供声明式的安全访问控制解决方案。
-
-
-
为什么要在油气行业中应用 IoT?这 8 个应用场景告诉你 IoT 在油气行业中可以做什么...
如今,物联网已经进入了各行各业:汽车、农业、绿色能源。物联网还将征服的领域之一是石油和天然气领域。在这些特殊的行业环境中,公司雇佣专业人员来预测机器何时需要维护和保养。通过物联网监控,以确保员工在工作环境中的安全,并改善生产。 麦肯锡 (McKinsey Global Institute)研究表明,到2025年,物联网有可能吸引$11.1T 的资金。
-
ES2020 是 ECMAScript 对应 2020 年的版本。这个版本不像 ES6 (ES2015)那样包含大量新特性。但也添加了许多有趣且有用的特性。本文的代码地址:https://github.com/ljianshu/Blog 本文以简单的代码示例来介绍 ES2020新特性。这样,你可以很快理解这些新功能,而不需要多么复杂的解释。
-
在本文中,我们将开始开发自己的Kubernetes控制器。 技术栈可以是Python、NodeJS或Ruby。因为这个博客被命名为为“ Java极客”,因此选择Java是很正常的。 作为一个用例,我们将实现sidecar模式:每当一个pod被调度时,sidecar pod也会随之被调度。如果将前者删除,则后者也必须删除。
-
-
其实“数据湖”的概念由来已久,如果追溯时间大概可以到2011年。如今我们经常提及的数据湖其实可以被认为是一个集中式的安全存储库,用户可以任何规模存储、管理、发现并共享所有结构化和非结构化数据,过程中无需预定义架构。
-
-
医疗保健、零售、金融、制造业……一文带你看懂大数据对工业领域的影响!...
随着大数据技术的兴起,工业领域在很大程度上发生了变化。智能手机和其他通讯方式的使用迅速增加,使得每天都能收集大量数据。以下是大数据对工业领域的影响。
-
2020年已经到来,它的到来带来了信息和技术(IT)领域的诸多创新和变革,特别是对DevOps技术的创新和变革。美国领先的调查机构Grand View Research的专家进行的一项研究宣称,预计到2025年,DevOps的市场价值将达到128.5亿美元。
-
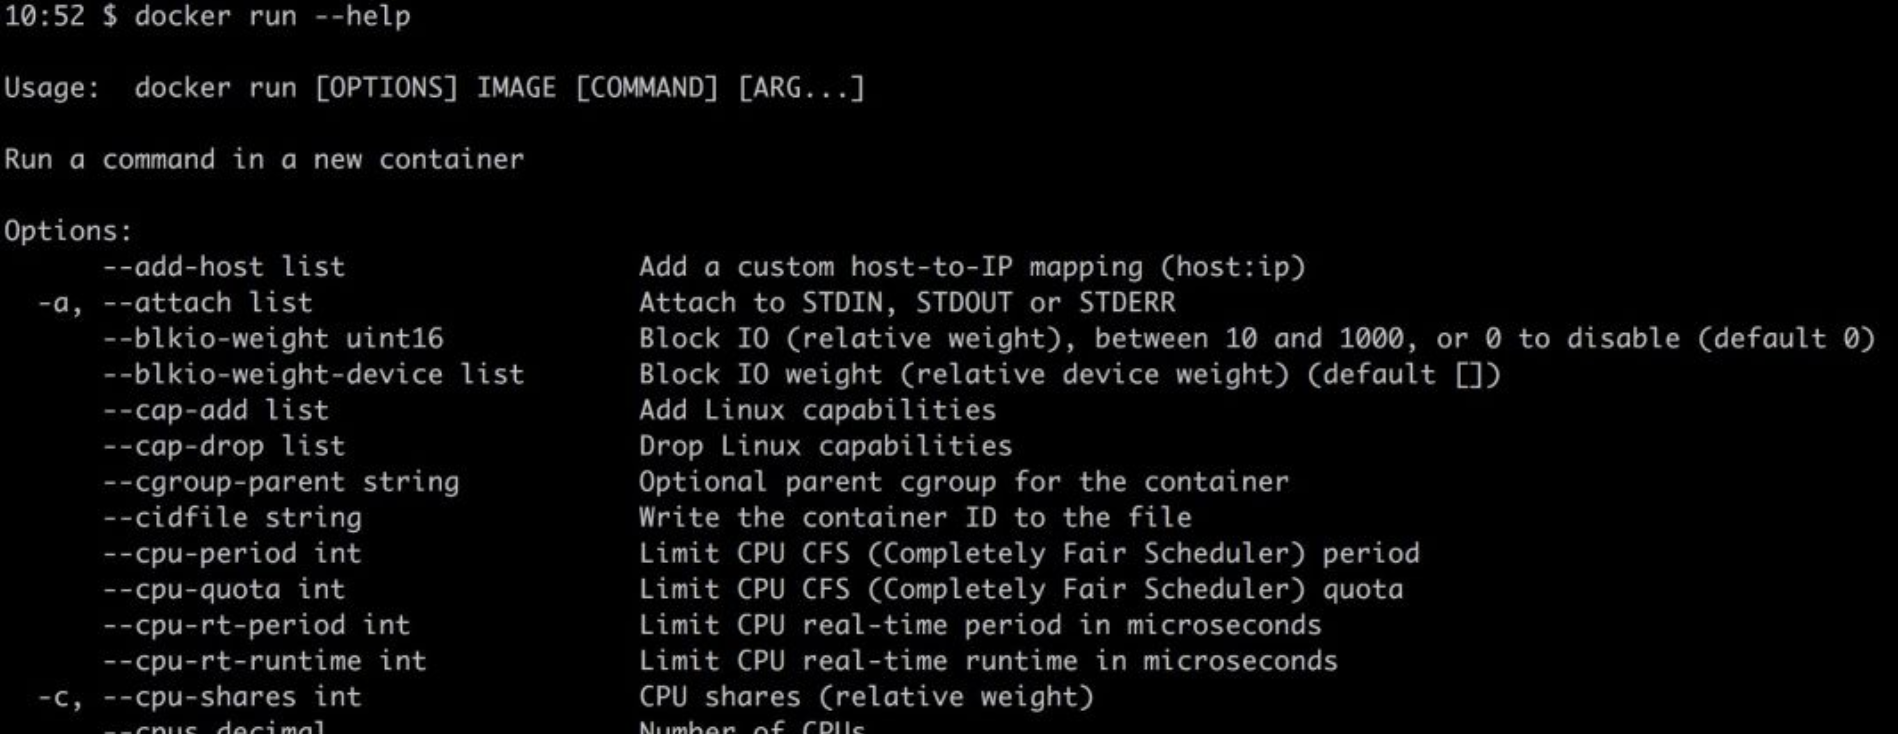
Docker容器已经从一种锦上添花的技术转变成了部署环境的必需品。有时,作为开发人员,我们需要花费大量时间调试或研究Docker工具来帮助我们提高生产力。每一次新技术浪潮来临之际,我们都需要花费大量时间学习。
-
SQL是用于数据分析和数据处理的最重要的编程语言之一,因此SQL问题始终是与数据科学相关工作(例如数据分析师、数据科学家和数据工程师)面试过程中的一部分。 SQL面试旨在评估应聘者的技术和解决问题的能力。因此,至关重要的是,不仅要根据样本数据编写正确的查询语句,而且还要像对待现实数据集一样考虑各种情况和极端情况。
-
近日,阿里云对外宣布其容器服务调度GPU云服务器启动加速计算,最快只需60秒即可完成新冠病毒的核酸对比工作;同时将向医疗科研机构、疾控中心等一线病毒研究机构免费开放基因计算服务,技术可大幅提升宏基因组测序、疫苗研发相关的处理效率。基于此,晶少专程采访了阿里云基因计算服务AGS负责人、高级技术专家李鹏,集中呈现针对GPU和容器技术大幅提升核酸比对速度的有关细节以及关于阿里云基因计算服务(AGS)的诸多信息。
-
最近,我构建了一个本地开发环境,该环境使用 Docker 进行一些关键的集成测试。 在我要完成这项工作时,我意识到在开始这项工作之前,我没有考虑到这么做的一些意义深远影响,如:
-
数据库连接池和线程池等池技术存在的意义都是为了解决资源的重复利用问题。在计算机里,创建一个新的资源往往开销是非常大的。而池技术可以统一分配,管理某一类资源,它允许我们的程序可以重复的使用这个资源,只有在极端情况下(比如连接池满)才会创建新的资源。
-
-
从提取层、处理层、基础结构入手,带你了解Spark和Kafka!
电子商务市场中典型的一天是这样的:每分钟发生1万个事件流,并且要选择合适的工具对其进行处理。
-
随着业务的发展,MySQL数据库中的表会越来越多,表中的数据量也会越来越大,相应地,数据操作的开销也会越来越大;另外,无论怎样升级硬件资源,单台服务器的资源(CPU、磁盘、内存、网络IO、事务数、连接数)总是有限的,最终数据库所能承载的数据量、数据处理能力都将遭遇瓶颈。
-
王坚博士曾经做过这样一个非常形象的比喻,他将做 App 比作是在别人的花园里弄盆栽,「种点花草是没有问题的」,不过「别人叫你的产品下架你就得下架,这是有问题的」,现在在 GitHub 上,众多的开发者显然遭遇了这样的问题。
活动
-
2021-11-10
-
2021-03-09
-
2020-12-16
独家定制
-
-
3500人的专业安全团队与你同在
-
-
CSDN云计算在线公开课
-

-
IaaS市场高速增长,历久弥新
精品推荐
关于我们
关注「云计算」
转载 & 投稿:songhui@csdn.net
商务合作:zhangjing@csdn.net