- 相关博文
- 最新资讯
-
/ mq_msg.proto —— 消息队列的消息类型定义// 生成 C++ 代码:// 会得到:// mq_msg.pb.h (声明)// mq_msg.pb.cc (实现,编译时必须一起链接!//// 文件名建议统一(下面按 mq_msg.proto 命名)。// 如果实际文件叫 message.proto,改一下 protoc 的输入即可,内容不变。// proto3 语法:字段默认值 = 0 / "" / false,且不能自定义默认值// 生成的类都在 bitmq 命名空间里。
-

- j7~
- 昨天
-
-
两台NVIDIA DGX Spark(GB10-4T)通过200G直连线组建双机集群,成功部署DeepSeek-V4-Flash 0731正式版与Vision-Exp视觉预览版,实现1M上下文、原生识图与投机解码全开。实测单并发速度达66.7 tok/s(8K上下文),6并发合计超147 tok/s,KV缓存池突破2.29M token。关桌面后稳定性提升,前缀缓存使首token延迟从66秒降至0.54秒。部署全程远程SSH管理,采用vLLM张量并行(TP=2),链路稳定高效,具备高可用与快速回滚能力。
-

- 星之所在瑶
- 昨天
-
-
📌今日行业事件集中在开源模型发布、企业经营与上市进展、终端产品适配、监管调查、技术论文迭代几个方向。Meta、阶跃星辰、英伟达、蚂蚁百灵相继开放多组大模型权重;Anthropic对外披露三季度经营数据,推进IPO流程。苹果智能确认接入国内大模型,计划在国内上线测试版本。监管机构针对头部AI企业启动安全相关调查。多篇学术论文围绕KV缓存压缩、弹性Transformer、智能体记忆机制输出研究成果。硬件端面向端侧的AI平台、可穿戴硬件陆续发布;同时出现线上服务故障、金融机构落地AI漏洞扫描等产业事件。
-

- AI日报派送佬
- 23小时前
-
-
本文从多类分类的边际理论出发,揭示FunctionCall在工具数超过临界点时突然失效的本质:工具选择实为in-context零样本多分类,其准确率依赖于正确类与竞争类间的logit margin。随着工具数K增加,极值理论表明margin随ln K衰减,导致分类准确率发生相变式坍塌。类间语义相似性加剧“logit分裂”与注意力稀释,ICL样本诅咒使性能非单调下降。全量注册违背两阶段检索-精读原则,应改用嵌入召回+小规模精读架构。核心工程法则包括控制有效工具数(K*≈10–30)、设计分类友好描述、实现按需
-

- 熊猫钓鱼>_>
- 昨天
-
-
Hermes Agent for Windows 一键安装脚本可免手动配置,自动完成 Git、uv、Python 等依赖安装,支持普通用户权限。执行 irm https://raw.githubusercontent.com/NousResearch/hermes-agent/main/scripts/install.ps1 | iex 即可部署,自动生成命令与 Web Dashboard,交互式配置 API Key 及网关。安装后通过 hermes 或 hermes dashboard 启动,支持 TUI
-

- AIGCExplore
- 22小时前
-
-
本文系统梳理了Git最常用的命令,按配置初始化、日常提交、分支管理、远程协作、撤销回退等实际场景分类,涵盖git status、git add、git commit、git push、git merge等核心操作,并附详细说明与示例。重点强调安全实践,如用git revert替代git reset避免历史污染,推荐git stash处理临时工作,提供.gitignore配置与reflog找回误删提交等实用技巧,帮助开发者高效掌握Git核心技能,实现流畅协作。
-

- 薛之谦_
- 23小时前
-
-
Meta 在 10 月 15 日把 Muse Spark Open 的权重搬上了 Hugging Face:816B 总参、42B 激活的 MoE,1M token 上下文,原生多模态,官方称其为迄今最强的美国开放权重模型。vLLM、SGLang 等 Day-0 支持,NVFP4 量化版把自托管门槛降到 700GB 显存级。但
-

- liferecords
- 23小时前
-
-
本指南介绍如何使用Elastic Observability监控Java应用,涵盖日志、指标、APM和Uptime四大方面。通过创建示例Java应用,配置Filebeat摄取日志并结构化处理,使用Metricbeat采集Prometheus指标,部署Elastic APM Java Agent实现性能追踪,并借助Heartbeat监控服务可用性与延迟。推荐使用Elastic OpenTelemetry SDK作为首选instrumentation方式。最终在Kibana中实现日志、指标、链路追踪与服务健康度
-
Spark + Fluss 让已有的 SQL 分析和 batch read 任务用上更新鲜的数据。通过 union read,Spark 可以在一次查询中组合湖中的历史数据与 Fluss 中的新数据,并处理主键更新,无需业务侧手动拼接两份结果。
-

- 阿里云大数据AI技术
- 昨天
-




-
-
-
-
-
王坚博士曾经做过这样一个非常形象的比喻,他将做 App 比作是在别人的花园里弄盆栽,「种点花草是没有问题的」,不过「别人叫你的产品下架你就得下架,这是有问题的」,现在在 GitHub 上,众多的开发者显然遭遇了这样的问题。
-
-
刚刚获悉,腾讯在光网络设备和数据中心领域的两大硬件自研设计“OPC-4”和“TMDC”顺利通过OCP(Open Compute Project)审核并正式接受为官方开源贡献。这是腾讯在硬件领域的开源设计首次被OCP官方正式认可,同时,腾讯也成为中国首家对OCP有开源贡献的互联网公司。
-
NVIDIA今日宣布,在NVIDIA GPU Cloud (NGC)容器注册上,向交通运输行业开源NVIDIA DRIVE™自动驾驶汽车开发深度神经网络。
-
11月28日,阿里云正式开源机器学习平台 Alink,这也是全球首个批流一体的算法平台,旨在降低算法开发门槛,帮助开发者掌握机器学习的生命全周期。
-
近日,开源数据库厂商MongoDB与阿里云在北京达成战略合作,作为合作的第一步,最新版MongoDB 4.2数据库产品正式上线阿里云平台。
-
-
-
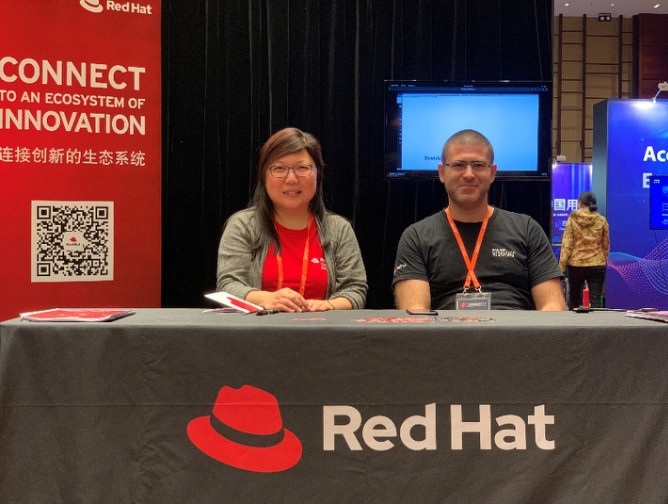
首次落地中国大陆的OpenInfra:中国对于开源做出的贡献力量已不可忽视
一张标志着上海现代建筑地标的东方明珠海报,另一张展示着上海悠久历史的豫园景区海报,不仅向我们展示了这座城市浓厚的历史气息与现代化的繁荣,也让我们看到了OpenStack历经9年历史背后仍有着新鲜的科技气息。仅从这两张景色迷人且拥有时尚气息的两张海报,便能够看出此次开源基础设施峰会的用心良苦。没错,前身为OpenStack Summit的Open Infrastructure Summit首次落地中国大陆,而此次也正是阿丹第一次参加这场盛会,深感荣幸。
-
四大开源项目联合发布 腾讯已成Github全球贡献前十公司!
近日在Techo开发者大会上,腾讯正式对四大重点开源项目进行了联合发布,包括分布式消息中间件TubeMQ、基于最主流的 OpenJDK8开发的Tencent Kona JDK、分布式HTAP数据库 TBase,以及企业级容器平台TKEStack。
-
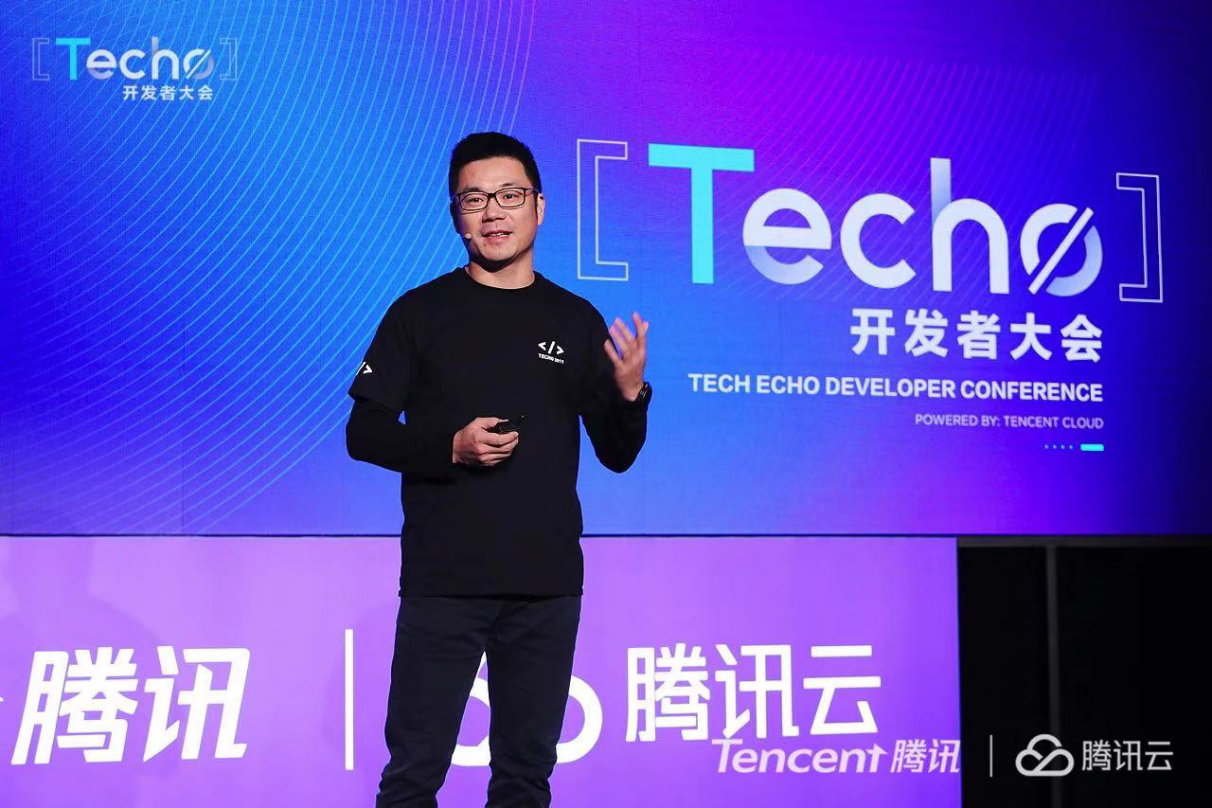
正式开源TKE和TBase,腾讯正成为大数据领域开源全面的厂商
在11月6日召开的Techo开发者大会上,腾讯云副总裁、腾讯数据平台部总经理蒋杰博士正式对外披露腾讯大数据平台10年技术演进历程。经过10年的积累,腾讯大数据平台的算力资源池目前已有超过20万台的规模,每天实时数据计算量超过30万亿条,并且随着资源管理平台核心TKE和分布式数据库TBase正式对外开源,腾讯正在成为大数据领域开源全面的公司。
-
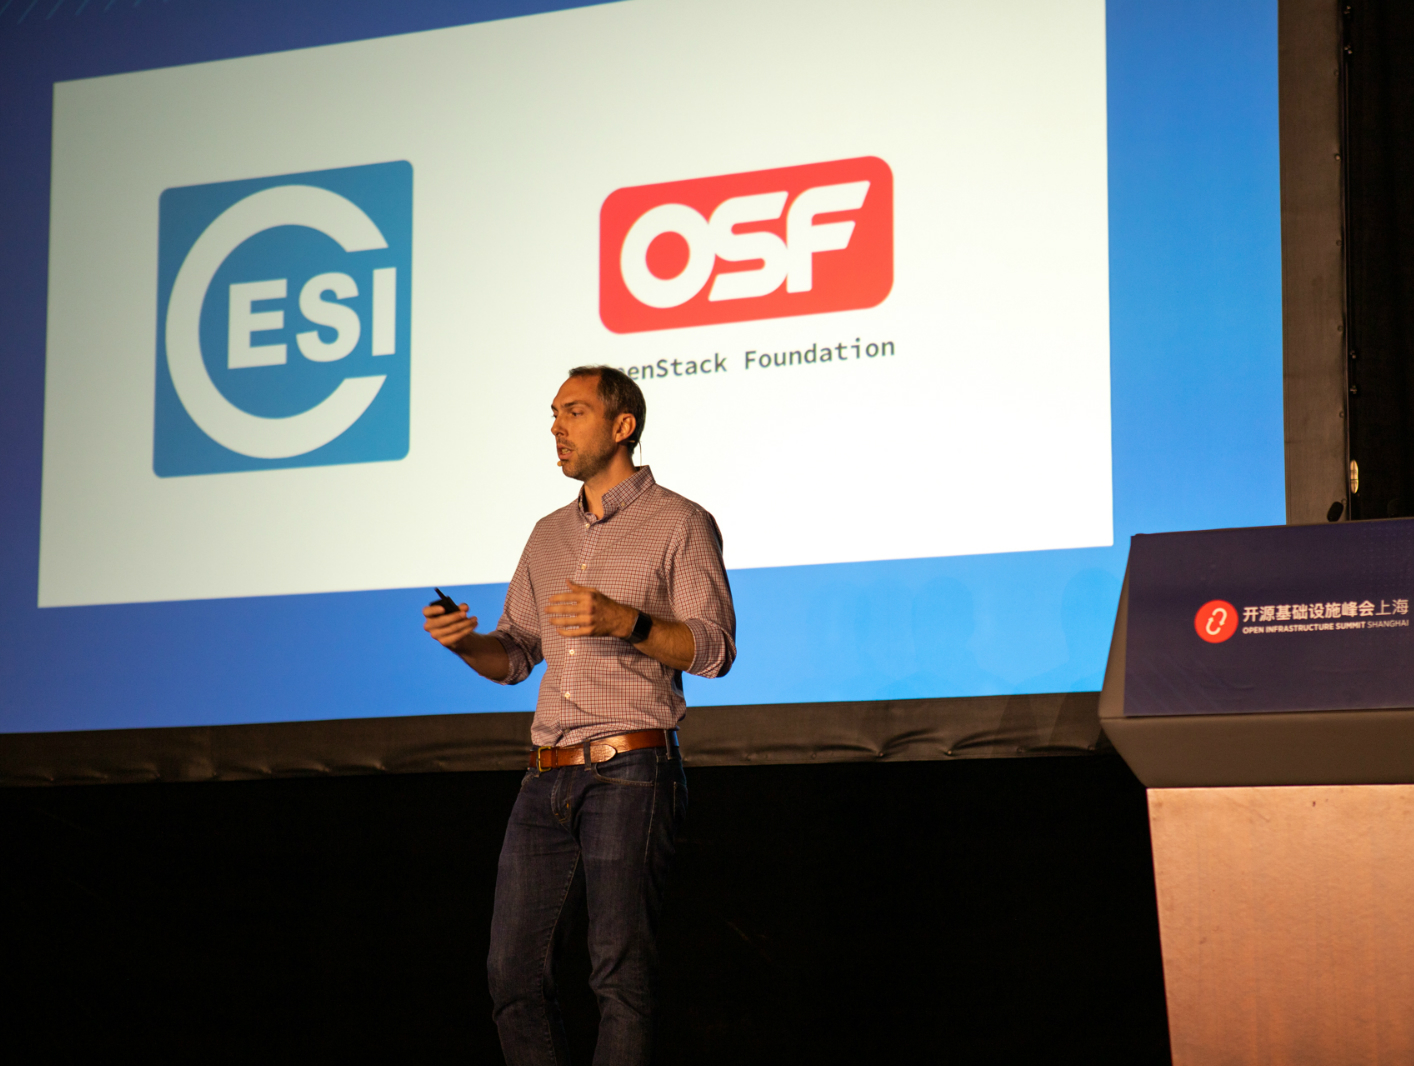
首次落地中国大陆的OpenInfra:中国对于开源做出的贡献力量已不可忽视
一张标志着上海现代建筑地标的东方明珠海报,另一张展示着上海悠久历史的豫园景区海报,不仅向我们展示了这座城市浓厚的历史气息与现代化的繁荣,也让我们看到了OpenStack历经9年历史背后仍有着新鲜的科技气息。仅从这两张景色迷人且拥有时尚气息的两张海报,便能够看出此次开源基础设施峰会的用心良苦。没错,前身为OpenStack Summit的Open Infrastructure Summit首次落地中国大陆,而此次也正是阿丹第一次参加这项盛会,并感到十分荣幸。
-
雪花算法(snowflake) :分布式环境,生成全局唯一的订单号
snowflake是Twitter开源的分布式ID生成算法,结果是一个long型的ID。 这种方案大致来说是一种以划分命名空间(UUID也算,由于比较常见,所以单独分析)来生成ID的一种算法,这种方案把64-bit分别划分成多段,分开来标示机器、时间等。 其核心思想是:使用41bit作为毫秒数,10bit作为机器的ID(5个bit是数据中心,5个bit的机器ID),12bit作为毫秒内的流水号,最后还有一个符号位,永远是0。
-
Q:什么是Spark?A:简单理解,Spark是在Hadoop基础上的改进,是UC Berkeley AMP lab所开源的类Hadoop MapReduce的通用的并行计算框架,Spark基于map reduce算法实现的分布式计算,拥有Hadoop MapReduce所具有的优点;但不同于MapReduce的是Job中间输出和结果可以保存在内存中,从而不再需要读写HDFS,因此Spark能更好地适用于数据挖掘与机器学习等需要迭代的map reduce的算法。
活动
-
2021-11-10
-
2021-03-09
-
2020-12-16
独家定制
-
-
3500人的专业安全团队与你同在
-
-
CSDN云计算在线公开课
-

-
IaaS市场高速增长,历久弥新
精品推荐
关于我们
关注「云计算」
转载 & 投稿:songhui@csdn.net
商务合作:zhangjing@csdn.net