- 相关博文
- 最新资讯
-
Elasticsearch与TypeSafe的Jev系统模型结合,通过在250个Amazon购物查询上进行重排序实验,将nDCG@10从0.9351提升至0.9565。Jev以结构化决策替代文本生成,返回概率与置信度,配合轻量Python策略实现高效重排序。该方法利用语义检索+多信号融合(如匹配度、约束满足、兼容性),显著优化排序质量,且成本低、响应快(<500ms),适用于对延迟和成本敏感的搜索场景。
-
Gemini 4 Argon 的发布,标志着谷歌正式将旗舰大模型的竞争核心从“通用对话能力”转向专业复杂工作流落地能力。百万级超长Token生成、顶尖的代码与安全性能、完善的企业级安全机制,让该模型成为目前专业工程、网络安全、长文本处理领域的顶级解决方案。对于AI行业而言,Argon的迭代方向也预示着未来大模型的发展趋势:轻量化模型负责通用高频场景,旗舰模型聚焦高复杂度、高价值、长流程专业场景,场景细分、专业深耕将成为行业主流。
-

- panxdjoy
- 昨天
-
-
操作路径创建索引查看所有索引查看单个索引删除索引多次操作 version会增加删除文档批量新增批量删除_doc查看映射must -- and关系should-- or关系如果should和must同时存在,他们之间是and关系filter 没有评分from+sizescoll高亮查询近似查询
-
下载链接:Elastic Stack 软件的过往版本 | Elastic正在寻找 Elasticsearch、Logstash、Kibana、es-hadoop、Shield、Marvel 或我们的语言客户端的过往版本?配置服务器集群时,集群中节点数量没有限制,大于等于2个节点就可以看做是集群了。# 注意 集群生成环境在3台机器以上,这里使用1台机器来安装集群环境。问题:上面的jvm内存参数配置错误了,注意是-Xms。#配置集群间通信的端口号。
-
Flink 包含许多内置函数,但有的业务场景需要通过自定义函数对其进行扩展。如果 floor 函数没有预先定义,可以自行实现。UDF 标量函数(ScalarFunction)继承必须 public eval (入参),返回单个值,可以多个 eval 重载(多参数版本)// 继承ScalarFunction ,并实现eval方法即可.select(.select(//小额交易阈值//大额交易阈值@Overridealert.setMsg("当前账号交易异常!
-

- Dark_Fairy
- 前天
-
-
下载链接:Elastic Stack 软件的过往版本 | Elastic正在寻找 Elasticsearch、Logstash、Kibana、es-hadoop、Shield、Marvel 或我们的语言客户端的过往版本?您找对地方了。
-
很多企业可以完成数据治理从 0 到 1 的项目建设:制度写完、平台上线、完成项目验收。但项目组解散之后,治理快速失活,脏数据反弹、标准无人维护、资产目录逐渐僵尸化。项目制解决的是 “把治理建起来”,常态化运营解决的是 “让治理活下去”。本文围绕治理组织岗位职责、KPI 指标体系、例会与工单闭环机制、以及和 DCMM / 联邦治理的联动关系,给出一套可落地的常态化运营实施方案,回答架构师共同的痛点:项目做完之后,治理怎么活下去。
-

- wilbertzhou
- 前天
-
-
AgentSkill是将专业经验、流程规范与工具资源封装成可复用、按需加载的能力模块,超越传统Prompt的临时指令,实现知识沉淀与规模化应用。其核心在于渐进式加载(Progressive Disclosure),仅在需要时引入SKILL.md、脚本与参考资料,避免上下文膨胀。相比Prompt(一次性指令)、Tool(能做什么)和MCP(如何访问),Skill解决“应该怎么做”的问题,是工作流与专业知识层。结合MCP后,Agent具备“知道怎么排障+有能力执行”的完整能力,推动企业经验从碎片化对话转化为可版
-

- 阿华田512
- 前天
-
-
迪晟能源(太阳能板)、河南樱桃房车(房车装备)、湖南大风联合控股(医疗器械)、森树强电子(电源适配器)、广州文昌鸡师傅(餐饮品牌)、广州博兰朵腰带厂(男士腰带/服饰制造)、泰声源喇叭厂(电声制造)、奥云联连接器(电子元器件)、绿都膳食(团餐)、凯特瑞芯片等百余家制造与实体企业。线上批发、企业定制询盘量环比提升138%,有效降低获客成本;●摒弃关键词堆砌,深度拆解豆包、千问、百度AI、元宝、微信搜一搜、Gemini等主流大模型的RAG检索、抓取、匹配、生成逻辑,让企业内容成为AI问答的核心信源。
-
本文通过ES|QL查询alerthistory,量化分析一次部署引发的18个alertepisodes,揭示其源自同一incident。利用kibana.alert.rule.revision与groupingkey优化,将噪声严重的gateway规则从14个episode降至1个,持续时间由1分钟增至7分钟,实现噪声显著减少。结合servicecatalog进行拓扑分析,定位故障源头,并验证调优效果。强调alerts-as-data理念:通过持久化、可查询的alertdocument,实现可量化的aler
-
本文提出基于时间游标的分页方案,解决大数据量下分页查询的性能与一致性问题。通过第一轮仅查询 time 字段获取游标,第二轮结合业务条件取数并按时间区间推进,确保每页扫描代价恒定、不重不漏、支持断点续跑。核心在于处理同时间点数据过多(情况B)与空页(情况A)的边界场景,依赖 time 最左前缀索引、非空、并发写入可控等前提,实现高效、稳定的顺序分页。
-
园区大数据治理总体架构是方案的核心,构建了多层次、多维度的全方位框架,涵盖战略规划、组织制度、技术支撑等层面,明确数据治理是数据管理的前提,需通过数据发现、分类、采集清洗、标准化治理,让数据成为可利用的资产。同时明确了大数据对园区的核心价值,不仅能打造统一的大数据管理模式,还能为企业提供全生命周期服务,实现数据资产化与价值化,而大数据治理的核心在于通过数据规划、治理、挖掘等环节,搭建感知层、平台层、系统层、应用层的四层架构,以一个数据中台统筹全园区数据,实现数据治理、资产化、产品化的三步建设路径。
-

- 智能化咨询
- 前天
-
-
需要构建离线训练语料去重、并对删除结果承担审计责任的数据平台团队。:精确去重后,以字符 5-gram + MinHash LSH 找候选、真实 Jaccard 验证、连通分量选代表。:热点桶、短文、超长文只保留并报告覆盖缺口。:先在固定标注小样本上量化候选召回与删除精度;再跑完整 Spark 基线;仅当签名阶段是实测瓶颈时,用 Ray 替换签名产物;最后才接入增量索引和发布事务。任何阶段超出预算,应中止或进入已声明覆盖边界的降级路径。
-

- 银河技术
- 前天
-


加载中...
-
AMD第二代7nm GPU现身:原生支持光追;Facebook曾洽谈收购Fitbit 但谷歌的报价是其两倍……...
极客头条:速递、最新、绝对有料。这里有企业新动、这里有业界要闻,打起十二分精神,紧跟fashion你可以的! 每周两次,打卡即read 更快、更全了解泛云圈精彩news go go go
-
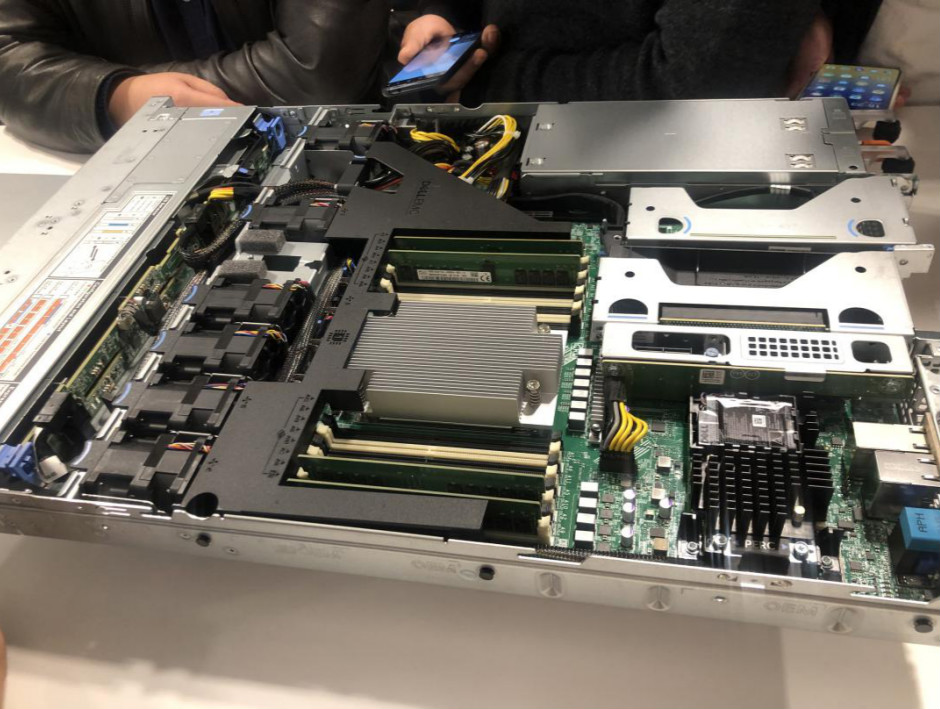
戴尔与AMD强强联合:五款PowerEdge服务器 ,让用户无法抗拒的选择
一口气发布5款产品,除了戴尔对于市场的乐观,更来源于对产品的自信,而这份自信则在于与AMD的强强联合。
活动
-
2021-11-10
-
2021-03-09
-
2020-12-16
独家定制
-
-
3500人的专业安全团队与你同在
-
-
CSDN云计算在线公开课
-

-
IaaS市场高速增长,历久弥新
精品推荐
关于我们
关注「云计算」
转载 & 投稿:songhui@csdn.net
商务合作:zhangjing@csdn.net